
Você não tem telemetria demais. Tem telemetria ruim.
Por Juraci Paixão Kröhling · · 5 min de leitura
Tradução do artigo original em inglês na Telemetry Drops. Autoria e data editorial preservadas.
Sumário
Resumo
O problema de muitas organizações é de governança, não de volume. Corrija a telemetria ruim na origem antes de aplicar amostragem.
A revisão trimestral do orçamento chega e a linha de observabilidade dobrou de novo. A reação é conhecida: “Precisamos de uma amostragem mais agressiva” ou “Vamos observar apenas os serviços críticos”. Essas medidas reduzem custos. Também podem destruir sua capacidade de depurar incidentes em produção, trocando um problema financeiro por um operacional.
A verdade incômoda é que muitas organizações não têm um problema de volume. Têm um problema de governança. Antes de ajustar a amostragem, líderes de engenharia deveriam perguntar: sabemos o que estamos coletando e vale a pena guardar esses dados?
A lacuna de governança
Muitas organizações não conseguem responder a três perguntas básicas sobre sua telemetria: o que coletamos? Quem é responsável? Qual é o valor desses dados?
A telemetria tende a crescer organicamente. Alguém habilita logs de depuração durante um incidente e esquece de desabilitá-los. A instrumentação automática captura chamadas de funções internas. Bibliotecas geram spans que ninguém examina. Ao longo dos meses e anos, esse acúmulo vira o patamar que todos consideram necessário.
O resultado é um acervo de telemetria que ninguém compreende, pelo qual ninguém se responsabiliza e cujo custo de retenção ninguém decidiu conscientemente assumir. Quando a conta chega, a amostragem parece ser a única opção. Ela trata toda a telemetria como igualmente valiosa e corta os dados indiscriminadamente.
Padrões de telemetria ruim
Antes de implementar amostragem, líderes de engenharia precisam entender os padrões que consomem recursos sem ajudar muito na investigação de problemas.
A enxurrada de health checks é um dos casos mais comuns. Probes do Kubernetes, verificações de balanceadores e sistemas de monitoramento geram milhões de rastros por dia. Eles confirmam que os serviços respondem, mas dizem pouco sobre o comportamento da aplicação, a experiência de quem a usa ou os gargalos do sistema. Competem com sinais úteis e consomem capacidade do pipeline.
Logs de depuração esquecidos em produção geram desperdício semelhante. Durante um incidente, aumentar a verbosidade ajuda a entender o sistema. Depois da resolução, a configuração permanece e produz volumes enormes de logs que ninguém consulta até a próxima cobrança.
Atributos de alta cardinalidade em métricas criam outro problema. Colocar identificadores de usuários ou transações nas dimensões parece útil até o backend de métricas enfrentar milhões de séries únicas. O custo cresce de forma multiplicativa com cada atributo adicional de alta cardinalidade.
A proliferação de spans internos acontece quando a instrumentação automática, especialmente via eBPF, captura cada chamada de método dentro de um serviço. Uma requisição pode gerar quinze spans, dos quais dez duram menos de um milissegundo e representam detalhes de implementação, em vez de fronteiras relevantes do sistema. Esses spans adicionam ruído sem ajudar a depuração.
Spans órfãos surgem quando a propagação de contexto entre serviços falha. Sem conseguir reuni-los em rastros coerentes, você perde a visão do fluxo da requisição. Eles consomem armazenamento e processamento sem fornecer o contexto necessário à investigação.
Corrija na origem
Muitas organizações tentam resolver o desperdício adicionando filtros ao pipeline de coleta. Isso deixa de lado a ineficiência inicial. Quando os dados chegam ao Collector, a aplicação já os gerou, serializou e transmitiu pela rede. Filtrar no Collector reduz o custo de armazenamento, mas os custos de computação e rede já ocorreram.
Corrigir na origem evita o desperdício. Excluir endpoints de health check na configuração dos agentes impede que esses rastros sejam criados. Políticas de nível de log nos deployments mantêm a depuração nos ambientes de desenvolvimento. Revisões de código podem identificar atributos de alta cardinalidade antes de chegarem à produção.
O Collector deve ser uma proteção adicional para casos que não podem ser resolvidos na origem, como aplicações legadas ou serviços de terceiros. Para os demais casos, prevenir a geração de dados desnecessários é a solução mais econômica.
A questão do volume continua
Mesmo depois de corrigir a telemetria ruim, algumas organizações ainda terão desafios legítimos de volume. Sistemas muito movimentados geram bastante telemetria mesmo quando cada span e log tem valor. A diferença está na decisão seguinte.
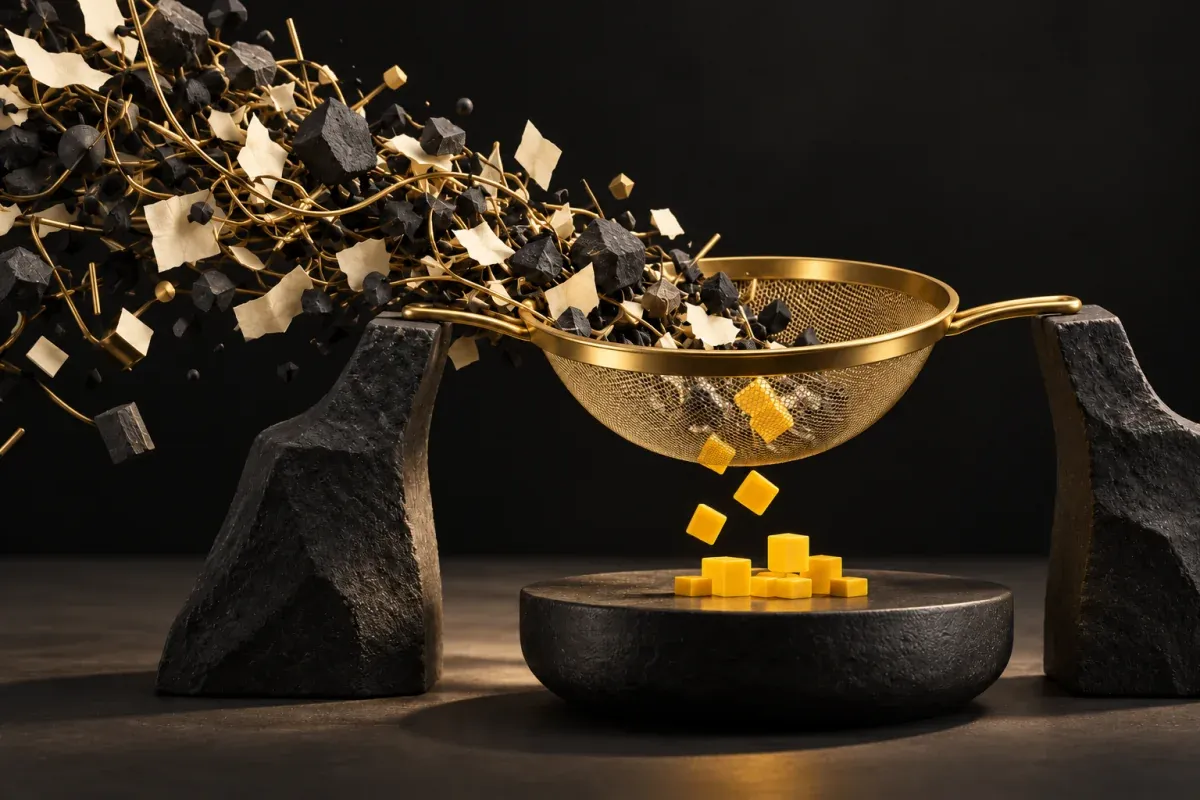
Amostragem de lixo produz uma pilha menor de lixo. Quando sinal útil e ruído estão misturados, a amostragem corta ambos. Você reduz custos e também sua capacidade de investigar justamente os incidentes cujos dados foram descartados.
Depois da limpeza, a amostragem se torna uma decisão estratégica sobre dados valiosos. Cada dado restante tem um propósito. As políticas passam a expressar escolhas conscientes entre custo e cobertura. A amostragem no final do rastro pode preservar erros e reduzir o volume de sucessos. Limites de taxa podem conter picos e manter uma visibilidade básica.
A limpeza também reduz o volume que precisa de amostragem. Muitas organizações descobrem que corrigir a telemetria ruim já traz os custos para níveis aceitáveis, sem cortes agressivos.
Uma abordagem prática para líderes de engenharia
Governança exige visibilidade antes da ação. Comece inventariando o que você coleta e identificando as maiores fontes de volume entre rastros, métricas e logs. É comum que poucas fontes respondam pela maior parte dos dados.
Classifique esse volume. Health checks, spans internos, logs de depuração e métricas de alta cardinalidade exigem estratégias de correção diferentes. Entender a composição orienta onde concentrar o esforço.
Avalie o valor com honestidade: quando cada categoria ajudou pela última vez a resolver um incidente? Se ninguém lembra de usar rastros de health checks para depuração, eles são candidatos à remoção ou à filtragem agressiva.
Implemente correções na origem quando possível. Configurações de agentes, políticas de nível de log e revisões da instrumentação atacam a causa. Reserve filtros no Collector para situações em que alterar a origem seja impraticável.
Se o volume continuar sendo um problema, aplique amostragem com intenção. Documente o que será amostrado e por quê. Preserve os rastros mais importantes para incidentes: erros, requisições de alta latência e tráfego de clientes específicos.
Sair dos cortes reativos e chegar à governança consciente exige esforço. A recompensa é um sistema de observabilidade que custa menos e funciona melhor. Na próxima conversa sobre orçamento, a resposta deve ser: “Sabemos exatamente o que coletamos e vale a pena manter esses dados”.
Principais conclusões
- Custos de telemetria exigem governança, além de controle de volume.
- Health checks, logs de depuração esquecidos e métricas de alta cardinalidade são fontes comuns de desperdício.
- Corrija na origem; filtros no Collector funcionam como uma proteção adicional.
- Amostragem depois da limpeza é uma decisão sobre dados valiosos.
Perguntas frequentes
Como reduzir custos com o OpenTelemetry Collector?
Comece auditando os dados coletados. Health checks, logs de depuração esquecidos e métricas de alta cardinalidade são fontes comuns de desperdício. Corrija a origem antes de adicionar filtros no Collector.
Devo usar amostragem para reduzir custos?
Primeiro elimine a telemetria ruim. Depois, faça escolhas conscientes de amostragem sobre os dados valiosos que restaram.
Ensino OpenTelemetry e engenharia de observabilidade com cursos e conteúdo prático em português.